[toc]
| 单词 | 词性 | 音标 | 含义 |
|---|---|---|---|
| Association | n. | /əˌsəʊsiˈeɪʃn/ | 关联(对一:查询结果中嵌套一个对象) |
| Collection | n. | /kəˈlekʃn/ | 集合(对多:查询结果中嵌套一个集合) |
| ResultMap | n. | /rɪˈzʌlt mæp/ | 结果映射(XML 中声明「查询列 → 对象属性」的规则) |
| Join | v. | /dʒɔɪn/ | 连接(JOIN 把多张表按关联条件拼成一张结果集) |
| Intermediate Table | - | /ˌɪntəˈmiːdiət ˈteɪbl/ | 中间表(多对多关系的桥梁表) |
| Stream | n. | /striːm/ | 流(Java 8 的集合处理 API) |
| toMap | - | /tuː mæp/ | 转成 Map(StreamAPI 收集器,按 key 建立索引) |
| Foreign Key | - | /ˈfɒrən kiː/ | 外键(一张表里指向另一张表主键的列) |
Lecture12-MyBatisPlus关联关系映射
一、关联关系的核心概念
前 11 章的所有操作都是单表的。但现实中的表之间通过外键相互关联,页面上的数据往往来自多张表:
t_emp表里的dept_id只是部门编号,页面上要显示的是「部门名称」- 点进一个部门,要看到这个部门下的所有员工
- 一个员工可以拥有多个角色(管理员、开发……)
这就要用到「关联关系」。先记住三种基本关系:
| 关系 | 示例 | 关联方式 | 常用查询方向 |
|---|---|---|---|
| 一对一 | 员工 ↔ 员工档案 | 档案表存 emp_id 外键 | 员工 → 档案;档案 → 员工 |
| 一对多 | 部门 ↔ 员工(多对一) | 员工表存 dept_id 外键 | 部门 → 员工列表;员工 → 所属部门 |
| 多对多 | 员工 ↔ 角色 | 中间表存 emp_id、role_id | 员工 → 角色列表;角色 → 员工列表 |
注意「多对一」和「一对多」是一体两面:站在员工看部门是多对一,站在部门看员工是一对多,底层都是外键
dept_id。多对多则必须借助中间表。
关键认知:MyBatis-Plus 的自动能力只覆盖单表。跨表关联的数据,有两种组装途径:
- MyBatis 原生映射:自己写一条关联 SQL +
association/collection映射规则,框架装出嵌套对象 - MyBatis-Plus 推荐做法:单表多次查询(SQL 自动生成)+ StreamAPI/Lambda 在 Java 里组装
本章把这两种做法各讲一个典型例子,最后处理两个常见的特殊情况,够日常开发使用。
二、MyBatis 原生映射方式:association(对一)与 collection(对多)
1、思路与文件约定
原生映射的思路是:一条关联 SQL 查出嵌套结构,映射规则写在 XML 文件。这是 MyBatis 本身的机制,MyBatis-Plus 完全兼容(接口里的自定义方法不影响原有的 BaseMapper 方法)。
三个约定(缺一不可):
- XML 文件放在
resources/mapper目录(MyBatis-Plus 默认扫描classpath*:/mapper/**/*.xml,无需额外配置) 言外之意:如果存放的目录不叫 mapper 那么就必须到配置文件中指定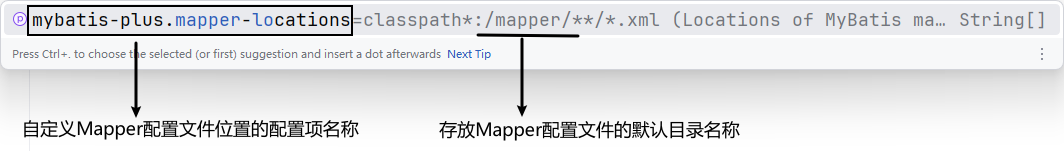
- XML 的
<mapper namespace>写 Mapper 接口的全类名 - 接口方法名与 XML 中
<select>的id一致,方法上不写任何注解,只留签名
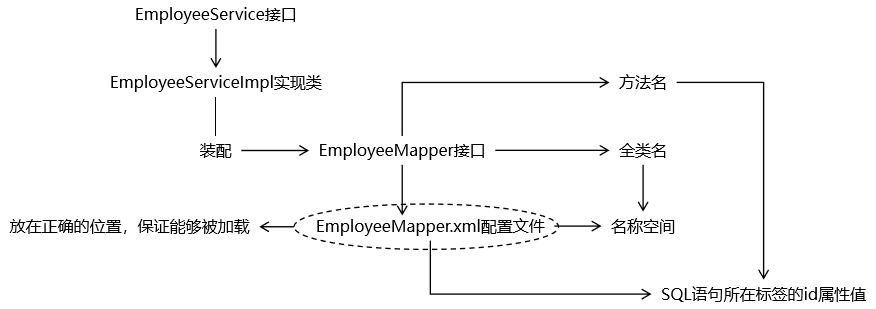
两个标签的分工:
| 标签 | 适用关系 | 装进属性 |
|---|---|---|
<association> | 对一(员工 → 部门) | 一个对象(employee.dept) |
<collection> | 对多(部门 → 员工) | 一个集合(dept.empList) |
注意:当我们自己在 Mapper.xml 配置文件写 SQL 语句,MybatisPlus 通过生成 SQL 语句附加的功能就都无效了,需要我们自己写!!! 比如:逻辑删除
2、对一:查询员工带部门(association)
①Mapper 接口新增方法(不加注解)
// SQL 与映射都在 XML 里,方法只写签名
Employee selectEmployeeWithDeptXml(@Param("empId") Integer empId);
②创建 resources/mapper/EmployeeMapper.xml
<?xml version="1.0" encoding="UTF-8"?>
<!DOCTYPE mapper PUBLIC "-//mybatis.org//DTD Mapper 3.0//EN"
        "http://mybatis.org/dtd/mybatis-3-mapper.dtd">
<mapper namespace="com.atguigu.mp.mapper.EmployeeMapper">

    <!-- 一对一:association 把查询出的部门列装进 employee.dept -->
    <resultMap id="employeeWithDeptMap" type="com.atguigu.mp.entity.Employee">
        <id column="emp_id" property="empId"/>
        <result column="emp_no" property="empNo"/>
        <result column="emp_name" property="empName"/>
        <result column="emp_salary" property="empSalary"/>
        <association property="dept" javaType="com.atguigu.mp.entity.Dept">
            <id column="dept_id" property="deptId"/>
            <result column="dept_name" property="deptName"/>
        </association>
    </resultMap>

    <select id="selectEmployeeWithDeptXml" resultMap="employeeWithDeptMap">
        SELECT e.emp_id, e.emp_no, e.emp_name, e.emp_salary, e.dept_id, d.dept_name
        FROM t_emp e LEFT JOIN t_dept d ON e.dept_id = d.dept_id
        WHERE e.emp_id = #{empId}
    </select>

</mapper>
③测试
@Test
public void testSelectEmployeeWithDeptXml() {
    Employee employee = employeeMapper.selectEmployeeWithDeptXml(1);
    System.out.println("员工 = " + employee.getEmpName());
    System.out.println("所属部门 = " + employee.getDept().getDeptName());
}
==>  Preparing: SELECT e.emp_id, e.emp_no, e.emp_name, e.emp_salary, e.dept_id, d.dept_name FROM t_emp e LEFT JOIN t_dept d ON e.dept_id = d.dept_id WHERE e.emp_id = ?
==> Parameters: 1(Integer)
结果里 employee.getDept() 就是一个完整的 Dept 对象(含 deptId、deptName)。
3、对多:查询部门带员工列表(collection)
①Mapper 接口
// 对多:查部门,并把该部门所有员工装进 dept.empList
List<Dept> selectDeptWithEmployees(@Param("deptId") Integer deptId);
②XML 中追加 resultMap 和 select
    <!-- 对多:collection 把多行员工装进 dept.empList -->
    <resultMap id="deptWithEmpMap" type="com.atguigu.mp.entity.Dept">
        <id column="dept_id" property="deptId"/>
        <result column="dept_name" property="deptName"/>
        <collection property="empList" ofType="com.atguigu.mp.entity.Employee">
            <id column="emp_id" property="empId"/>
            <result column="emp_name" property="empName"/>
            <result column="emp_salary" property="empSalary"/>
        </collection>
    </resultMap>

    <select id="selectDeptWithEmployees" resultMap="deptWithEmpMap">
        SELECT d.dept_id, d.dept_name, e.emp_id, e.emp_name, e.emp_salary
        FROM t_dept d LEFT JOIN t_emp e ON e.dept_id = d.dept_id
        WHERE d.dept_id = #{deptId}
    </select>
说明:JOIN 之后每个员工占一行,MyBatis 会按 resultMap 中
<id>(dept_id)把多行合并成一个部门对象,员工装进empList(具体去重合并机制本教程不展开,记住结果即可)。
③测试
@Test
public void testSelectDeptWithEmployeesXml() {
    Dept dept = deptMapper.selectDeptWithEmployees(1);
    System.out.println("部门 = " + dept.getDeptName());
    dept.getEmpList().forEach(e -> System.out.println("  员工:" + e.getEmpName()));
}
==>  Preparing: SELECT d.dept_id, d.dept_name, e.emp_id, e.emp_name, e.emp_salary FROM t_dept d LEFT JOIN t_emp e ON e.dept_id = d.dept_id WHERE d.dept_id = ?
==> Parameters: 1(Integer)
④语法关键点
| 标签名 | 功能 | 属性名 | 属性功能 |
|---|---|---|---|
| id | 映射主键字段 | column property | 指定数据库表字段名称 指定实体类对象属性名 |
| result | 映射非主键普通字段 | column property | 指定数据库表字段名称 指定实体类对象属性名 |
| association | 映射对一关联关系 | javaType | 指定一的一端实体类类型全类名 |
| collection | 映射对多关联关系 | ofType | 指定多的一端实体类类型全类名 |
4、图解:XML resultMap 结构
5、注意事项
namespace与接口全限定名、方法名与<select>的id必须一一对应,否则运行时报「Invalid bound statement (not found)」- 自定义 SQL 不享受 MyBatis-Plus 的自动功能:逻辑删除等条件自己写(如
AND e.deleted = 0) - resultMap 中没列出的列不会映射:
SELECT要写全需要的列 - 对一用
<association>,对多用<collection>(ofType写集合元素类型)
三、MyBatis-Plus 不写 SQL:StreamAPI + Lambda 组装对象(推荐)
1、思路
原生映射要自己写一条 JOIN SQL;MyBatis-Plus 更常用的做法是完全不写 SQL:
- 单表查询(SQL 由 MyBatis-Plus 自动生成)
- 关联信息用第二次单表查询补齐
- 用 StreamAPI + Lambda(
toMap/groupingBy)按主键把两次结果组装成一个完整对象
优点:SQL 全部自动生成、逻辑透明、天然适配分页(见第四章)。日常开发优先推荐这种方式。
2、示例:查询员工列表并补上部门名称
@Test
public void testAssembleDept() {
    // ① 查员工列表(单表,MP 自动生成 SQL)
    List<Employee> employeeList = employeeMapper.selectList(null);

    // ② 收集所有 dept_id(去重)
    List<Integer> deptIds = employeeList.stream()
            .map(Employee::getDeptId)
            .filter(Objects::nonNull)
            .distinct()
            .toList();

    // ③ 一次性批量查询部门(IN 查询,一条 SQL)
    List<Dept> deptList = deptMapper.selectBatchIds(deptIds);

    // ④ 转成 Map:deptId -> Dept,方便按 id 取
    Map<Integer, Dept> deptMap = deptList.stream()
            .collect(Collectors.toMap(Dept::getDeptId, dept -> dept));

    // ⑤ 逐个填充到员工对象
    employeeList.forEach(e -> e.setDept(deptMap.get(e.getDeptId())));

    // 查看结果:员工对象里带着部门
    employeeList.forEach(e -> System.out.println(
            e.getEmpName() + " -> " + (e.getDept() == null ? "无部门" : e.getDept().getDeptName())));
}
控制台日志(两次查询,全程没有手写 SQL):
==>  Preparing: SELECT emp_id,emp_no,emp_name,emp_salary,emp_birthday,phone_num,dept_id FROM t_emp WHERE deleted=0
==>  Preparing: SELECT dept_id,dept_name FROM t_dept WHERE dept_id IN ( ? , ? )

3、N+1 问题:为什么不能逐条查关联数据
第 2 节示例里,补部门名称用的是 selectBatchIds 一次 IN 查询。如果换成「for 循环里逐个查」,就会踩中著名的 N+1 问题:
- 第 1 次查询:查出 N 条员工记录(1 次 SQL)
- 接下来:为每个员工单独查一次部门(N 次 SQL)
- SQL 总数 = 1 + N 次,名字就是这么来的
// ❌ 错误写法:for 循环里逐个查部门 → 1 + N 次 SQL
for (Employee e : employeeList) {
    Dept dept = deptMapper.selectById(e.getDeptId());   // 每个员工 1 次
    e.setDept(dept);
}
// 100 个员工 → 101 次 SQL,员工越多越慢
危害:SQL 次数与数据量成正比,每次 SQL 都有数据库往返和解析开销——100 个员工 101 次 SQL 还能忍,1000 个员工就是 1001 次 SQL,页面会明显变慢。
正确做法就是第 2 节的写法:收集 dept_id 集合 → 一次 IN 查询拿回全部部门 → 内存里组装,SQL 总数固定为 2 次,与员工数量无关。
提示:MyBatis 原生的「嵌套查询」(
association/collection里再指定一个 select)本质上也是 N+1,所以第二章只介绍了「一条 JOIN」的写法;日常开发优先用批量查 + 组装。
4、要点小结
- 补关联字段的固定套路:收集外键 →
selectBatchIds/listByIds一次 IN 查询 →toMap建索引 → 组装(避免 N+1,见第 3 节) toMap按主键建立索引,组装时按 id 取值是 O(1)- 员工实体里的
dept字段要加@TableField(exist = false)(表中没有对应列,仅用于组装),部门实体里的empList同理
四、特殊情况的处理
1、分页涉及多张表:不能使用关联查询
①问题:JOIN 分页会导致 count 计算错误
分页时 MyBatis-Plus 分页插件会自动生成一条 count 语句统计总记录数。如果分页 SQL 里用了 JOIN 且把「多」的一侧展开(比如部门 JOIN 员工),主表(部门)的每一行会重复出现:
- count 把重复的行也数进去 → 总记录数错误
- 总记录数错 → 总页数跟着错 → 分页错乱
②正确做法:先分页主表,再批量补关联
分页在主表上先查,再给本页记录补关联信息,count 只数主表、天然正确:
// 目标:部门分页列表,每个部门带上员工列表
// 1、先分页查主表 t_dept(MP 自动生成 SQL,count 只数部门)
IPage<Dept> page = new Page<>(1, 2);
deptService.page(page);
List<Dept> deptList = page.getRecords();

// 2、收集本页部门的 dept_id
List<Integer> deptIds = deptList.stream()
        .map(Dept::getDeptId)
        .toList();

// 3、按 dept_id 批量查员工(IN 一条 SQL)
List<Employee> employeeList = employeeService.lambdaQuery()
        .in(Employee::getDeptId, deptIds)
        .list();

// 4、把员工按部门分组:deptId -> List<Employee>
Map<Integer, List<Employee>> deptId2EmpList = employeeList.stream()
        .collect(Collectors.groupingBy(Employee::getDeptId));

// 5、组装:给每个部门填充员工列表
deptList.forEach(dept -> dept.setEmpList(deptId2EmpList.get(dept.getDeptId())));

// 6、输出验证
System.out.println("总记录数 = " + page.getTotal());   // 正确
System.out.println("总页数 = " + page.getPages());     // 正确
==>  Preparing: SELECT COUNT(*) AS total FROM t_dept
==>  Preparing: SELECT dept_id,dept_name FROM t_dept LIMIT ?
==>  Parameters: 2(Long)
==>  Preparing: SELECT emp_id,emp_no,emp_name,emp_salary,emp_birthday,phone_num,dept_id FROM t_emp WHERE deleted=0 AND dept_id IN ( ? , ? )
口诀:分页不 JOIN。只要分页涉及多张表,一律「先分页主表 → 收集外键 → IN 批量查关联表 → 组装」。
2、多对多 + 中间表:只查一部分数据的最佳策略
⓪为什么多对多需中间表
比如老师和学生的关联关系:
- 老师对应的学生 id:1、2、3、4、5、6、7、8
- 学生对应的老师 id:9、8、7
如果没有中间表,数据库表就没法体现这个关联关系,因为一个字段无法保存多个值。
具体来说,就是老师表中学生 id 这个外键列无法保存多个值
此时必须用中间表来表示:
| 中间表自身的主键字段 | 老师表的 id | 学生表的 id |
|---|---|---|
| 1 | 9 | 1 |
| 2 | 9 | 2 |
| 3 | 9 | 3 |
| 4 | 8 | 4 |
| 5 | 8 | 5 |
| 6 | 8 | 6 |
| 7 | 7 | 7 |
| 8 | 7 | 8 |
①场景与前提
员工和角色是多对多,通过中间表 t_emp_role(存 emp_id、role_id)关联。本节的前提是:不管是基于查询条件还是分页,都只查询一部分数据。
此时如果「员工 JOIN 中间表 JOIN 角色表」,会出现两个问题:主表行重复导致 count 错误(同上),而且把大量不需要的角色行也查出来了。
②最佳策略:不 JOIN,中间表当普通表分三步查
先按条件/分页查出主表的一部分 → 查中间表(IN 主键)→ 查角色表(IN 角色ID)→ 组装。每一步都是单表查询(SQL 自动生成),只查需要的数据,count 也天然正确。
// 目标:按条件查出部分员工,每个员工带上角色列表
// 前提:查询带条件 / 分页 → 只查询一部分数据

// 1、按条件查询部分员工(比如部门 1 的员工;分页场景把 .list() 换成 .page() 即可)
List<Employee> employeeList = employeeService.lambdaQuery()
        .eq(Employee::getDeptId, 1)
        .list();

// 2、收集员工 ID
List<Integer> empIdList = employeeList.stream()
        .map(Employee::getEmpId)
        .toList();

// 3、查中间表:按 emp_id 批量查,得到 (empId, roleId) 关系
List<EmpRole> empRoleList = empRoleService.lambdaQuery()
        .in(EmpRole::getEmpId, empIdList)
        .list();

// 把中间表结果按员工分组:empId -> List<roleId>
Map<Integer, List<Integer>> empId2RoleIds = empRoleList.stream()
        .collect(Collectors.groupingBy(EmpRole::getEmpId,
                Collectors.mapping(EmpRole::getRoleId, Collectors.toList())));

// 4、收集需要查的角色 ID,批量查角色表
List<Integer> roleIdList = empRoleList.stream()
        .map(EmpRole::getRoleId)
        .distinct()
        .toList();
Map<Integer, SysRole> roleMap = sysRoleService.listByIds(roleIdList).stream()
        .collect(Collectors.toMap(SysRole::getRoleId, role -> role));

// 5、组装:每个员工按分组结果取角色
employeeList.forEach(e -> {
    List<Integer> roleIds = empId2RoleIds.getOrDefault(e.getEmpId(), Collections.emptyList());
    e.setSysRoleList(roleIds.stream()
            .map(roleMap::get)
            .filter(Objects::nonNull)
            .toList());
});
==>  Preparing: SELECT emp_id,emp_no,emp_name,emp_salary,emp_birthday,phone_num,dept_id FROM t_emp WHERE deleted=0 AND dept_id=?
==>  Preparing: SELECT id,emp_id,role_id FROM t_emp_role WHERE emp_id IN ( ? , ? )
==>  Preparing: SELECT role_id,role_name FROM t_role WHERE role_id IN ( ? )
③为什么不用「一条 SQL(XML resultMap)」?
多对多也可以像标题二那样,在 Mapper.xml 里写一条「员工 JOIN 中间表 JOIN 角色表」的 SQL,用 collection 把角色装进员工。但在只查一部分数据的前提下,这种写法有两个绕不开的问题:
- 分页 count 会错:JOIN 展开后,一个员工有几个角色就占几行(主表行重复),分页插件自动统计的总记录数会把重复行算进去,总数和总页数就错了
- 会查出不必要的数据:JOIN 是"全量展开",只要查出这批员工,他们的所有角色都会被带出来,结果集被放大,做不到"查多少拿多少"
而「分三次查 + 组装」的方案:count 只数主表、天然正确;每一步只查需要的行。SQL 虽然多了两条,但都是简单的单表查询,逻辑透明、好调试,整体更可控。
补充:XML 一条 SQL 并非一无是处——查「单个对象的完整嵌套详情」(不分页、一次查全)时它更简洁、数据库往返更少,团队有 SQL 审查规范时也便于 DBA 统一优化。两种做法可以按场景共存,但列表 / 分页场景优先用多次查询组装。
要点回顾:
- 中间表就是一个普通表,照常用
lambdaQuery()单表查 - 全程不 JOIN:不会行重复、分页 count 正确
- 只查需要的数据:中间表只查这 N 个员工的记录,角色表只查这 N 个员工用到的角色
五、本章小结
- 三种关联关系:一对一、一对多(多对一)、多对多(中间表)
- 原生映射:一条 JOIN SQL + XML
<association>(对一)/<collection>(对多),由框架装出嵌套结构 - MP 推荐做法:不写 SQL,单表多次查询 + StreamAPI/Lambda(
toMap/groupingBy)组装,逻辑透明、分页友好 - 特殊情况①:分页多表不能 JOIN(主表行重复 → count 错误),先分页主表再 IN 批量补关联
- 特殊情况②:多对多 + 中间表,只查一部分数据时「分页/条件查主表 → IN 查中间表 → IN 查关联表 → 组装」,全程不 JOIN
至此,关联关系映射这一章讲完。下一章将介绍逆向工程(代码生成器),实现「建表 → 一键生成骨架代码」的开发提效。