day09 模块和包
1. 模块
1.1 全部导入
import 模块名 这种方式属于全部导入 即导入对应模块中的全部内容
在当前模块中都可以访问
"""
    module_1模块
"""

a = 100

b = 200

c = 300

def fun1():
    print("函数1")

def fun2():
    print("函数2")

def fun3():
    print("函数3")
"""
    导入并且使用我们创建好的module_1

    import 模块名 这种方式属于全部导入 即导入对应模块中的全部内容
    在当前模块中都可以访问
"""

import module_1 # [as 别名]

print(module_1.a)
print(module_1.b)
print(module_1.c)

module_1.fun1()
module_1.fun2()
module_1.fun3()
1.2 模块取别名
"""
    导入全部内容 并且给模块取别名 这种方式适用于模块名比较长的场景下
"""

import module_1 as m1

print(m1.a)
print(m1.b)
print(m1.c)

m1.fun1()
m1.fun2()
m1.fun3()
1.3 局部导入
"""
    导入部分内容(局部导入) 这种方式属于 用到哪些 导入哪些
"""

from module_1 import a , b , c

print(a)
print(b)
print(c)

# func1()
# func2()
# func3()
"""
    导入部分内容(局部导入) 这种方式属于 用到哪些 导入哪些
"""

from module_1 import a as a1 # 这里可以给导入的内容取别名 但是不能给模块取别名了
from module_1 import b
from module_1 import c


# print(a) # 这里报错 因为a已经被a1别名覆盖了
print(a1)
print(b)
print(c)

# func1()
# func2()
# func3()
1.4 重名问题
注意不同模块中内容同名的问题 后续导入的会覆盖前边导入的同名内容
# modu_1模块
num = 100
# modu_2 模块
num = 200
import modu_1
import modu_2

print(modu_1.num)
print(modu_2.num)
"""
    注意不同模块中内容同名的问题 后续导入的会覆盖前边导入的同名内容
"""

from modu_1 import num
from modu_2 import num

print(num) # 这里使用的都是 modu_2中的num
print(num) # 这里使用的都是 modu_2中的num
1.5 import * 的方式导入
使用import * 的方式 不会导入下划线开头的内容
这种方式生产环境严禁使用 直到有这种方式即可 因为这种方式会造成严重的命名污染
"""
    mo_1 模块 包含一些名字以单个下划线开头的内容
"""

a = 1
_b = 2

def f1():
    return 100

def _f2():
    return 200
"""
    测试  import *
    *在IT行业中 通常表示所有

    使用import * 的方式 不会导入下划线开头的内容
    这种方式生产环境严禁使用 直到有这种方式即可  因为这种方式会造成严重的命名污染
"""

from mo_1 import *

a = "abc"

print(a) # 这里将使用上方的q 取值为"abc" 而 导入的a将被覆盖了


from mo_1 import *

print(a)

# print(_b)

print(f1())
# print(f2())
"""
    使用全部导入的方式 测试下划线开头的内容
"""

import mo_1 as m1

print(m1.a)
print(m1._b)  # Access to a protected member _f2 of a module  访问了受保护的内容 不推荐

print(m1.f1())

print(m1._f2()) # Access to a protected member _f2 of a module  访问了受保护的内容 不推荐
1.6 模块的查找顺序
模块的导入顺序介绍 Java中如果你书写了一个和JDK提供的完全同名的类 包名相同 类名也相同 不会覆盖JDK提供的类 因为Java是通过双亲委派机制来解决这个问题的
当JVM类加载需要加载类 先通过父加载器进行加载(先从JDK提供的类中找)
比如你书写了java.lang.String 那么JDK加载这个类会先从JDK自身携带的类中进行查找 如果找了则直接加载使用
Python模块的查找顺序 1.先从内置模块中查找(直接打包编译在Python.exe文件中的模块) 2.当前目录 3.PYTHONPATH环境变量 4.标准库(安装Python解释器自带的库 并没有被编译到Python.exe文件中的) 5.第三方库
通过sys.path 属性查看模块的查找顺序
"""
    模块的导入顺序介绍
    Java中如果你书写了一个和JDK提供的完全同名的类 包名相同 类名也相同
    不会覆盖JDK提供的类 因为Java是通过双亲委派机制来解决这个问题的

    当JVM类加载需要加载类 先通过父加载器进行加载(先从JDK提供的类中找)

    比如你书写了java.lang.String  那么JDK加载这个类会先从JDK自身携带的类中进行查找
    如果找了则直接加载使用

    Python模块的查找顺序
    1.先从内置模块中查找(直接打包编译在Python.exe文件中的模块)
    2.当前目录
    3.PYTHONPATH环境变量
    4.标准库(安装Python解释器自带的库 并没有被编译到Python.exe文件中的)
    5.第三方库

    通过sys.path 属性查看模块的查找顺序

"""

import time
import sys

print("程序开始执行,即将进入休眠1秒钟")

path_list = sys.path

path_list.append("C:\\Users\\WHD\\Desktop\\视频")

path_list.insert(0,"D:\\")

print(path_list) # 以列表的形式呈现 查找顺序

time.sleep(1) # 休眠指定数值的秒钟

print("休眠结束,程序执行完毕")
def sleep(num):
    print("哈哈哈 没有休眠",num)
1.7 __ all __ 属性
使用import * 只能访问 在__all__属性中指定的内容
"""
    模块 m_1
"""

__all__ = ["a","add"]

a = 1
b = 2

def add(num1,num2):
    return num1 + num2


def sub(num1,num2):
    return num1 - num2
"""
    使用import * 只能访问 在__all__属性中指定的内容
"""

from m_1 import *

print(a)
# print(b) 访问报错 因为在__all__属性没有列举

print(add(1, 2))
# print(sub(1, 2)) 访问报错 因为在__all__属性没有列举
"""
    如果不使用import * 的方式 那么所有内容都可以正常访问
"""

import m_1 as m1

print(m1.a)
print(m1.b)
print(m1.add(1,2))
print(m1.sub(1,2))
1.8 __ name __ 属性
在 Python 中,__ name __ 是一个特殊的内置变量
Ø 当一个Python文件被直接运行时,该文件的 __ name 属性值为 main __。
当一个Python文件作为模块被导入时,__ name __属性会被设置为该模块的名称(即文件名,不包含 .py 后缀)。
"""
    模块 m_1
"""

a = 100
b = 200

# 如果有些代码 只需要在当前模块中执行 那么可以放在以下条件判断中
if __name__ == '__main__':
    print(__name__) # 在本模块中 __name__属性为 main
    print("在模块m_1中打印",(a + b))
import m_1
print(m_1.__name__) # 在不同的模块中 对于导入的模块 其名称为 模块名
print(__name__)
import this # 只导入这个模块 会打印Python之禅
1.9 dir()函数
dir()是一个内置函数,主要用于列出对象的属性和方法,或者列出当前作用域中定义的名称,并以一个字符串列表的形式返回。
"""
    dir()是一个内置函数,主要用于列出对象的属性和方法,或者列出当前作用域中定义的名称,并以一个字符串列表的形式返回。
"""

import m_1
import math
import sys

print(dir(m_1))
print(dir(math))
print(dir(sys))

print(dir([1, 2, 3]))
print(dir((1,2,3)))
print(dir({1,2,3,4}))
print(dir({"a":"A","b":"B","c":"C"}))

class Person:
    def eat(self):
        pass
    pass

p = Person()
print(dir(p))
2. 包
2.1 直接导入包
测试包的导入 如果直接导入包 那么包中的模块默认是不会导入的 除非在包中的 __ init __文件中显式指定了导入相关的模块
from . import circle
from . import rectangle

__all__ = ["circle","rectangle"]
"""
    圆形 模块
"""

PI = 3.1415926


def area(radius):
    return PI * radius * radius


def perimeter(radius):
    return 2 * PI * radius
"""
    矩形 模块
"""

def area(width, height):
    return width * height


def perimeter(width, height):
    return 2 * (width + height)
"""
    测试包的导入
    如果直接导入包 那么包中的模块默认是不会导入的 除非在包中的
    __init__文件中显式指定了导入相关的模块
"""

import graphic as g

print(g.circle.area(10))
print(g.rectangle.area(10,20))
2.2 导入指定的模块
"""
    导入指定的模块
"""

from graphic import circle,rectangle

print(circle.area(10))
print(rectangle.area(10,20))
2.3 import * 的情况
使用 import * 这种方式 所使用的内容必须书写在 包中__ init __.py文件的
__ all __ 属性中 (跟模块一样的机制)
__all__ = ["circle","rectangle"]
"""
    import * 的情况
    使用 import * 这种方式 所使用的内容必须书写在 包中__init__.py文件的
    __all__ 属性中 (跟模块一样的机制)
"""

from graphic import *


print(circle.area(10))
print(rectangle.area(10,20))
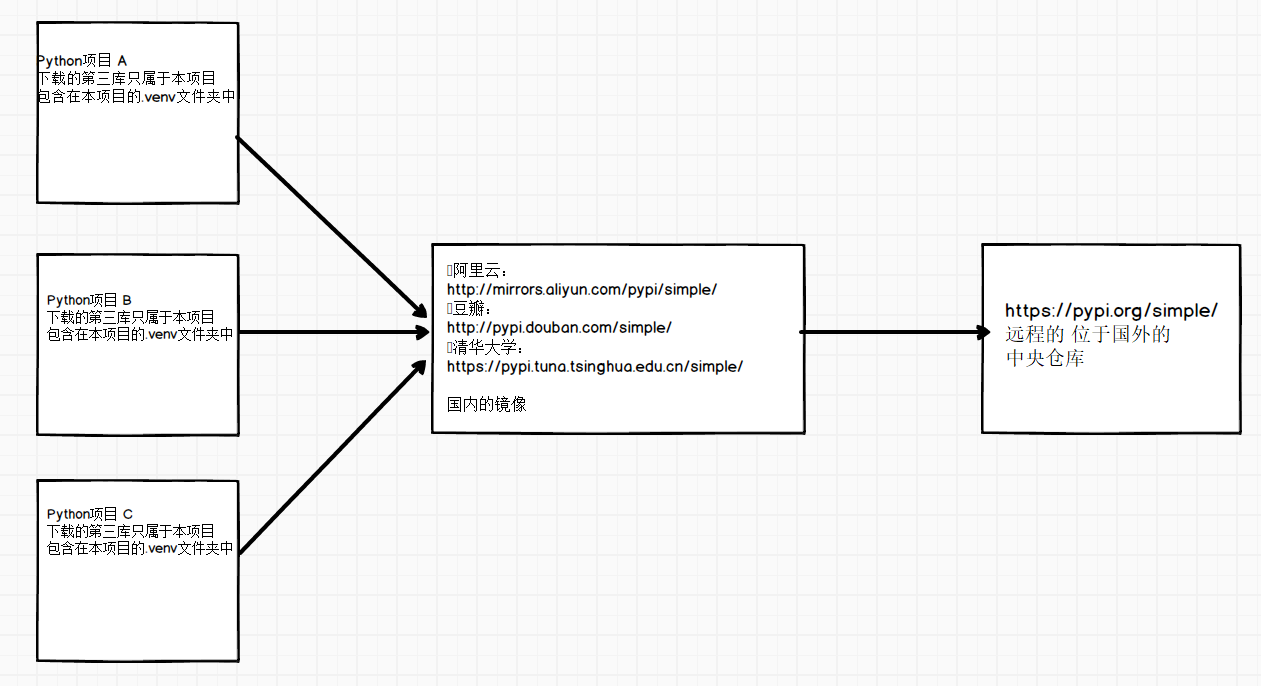
3. 仓库、源
4. 打包和安装
-
-
通过pip工具 先安装setuptools第三方库
-
编写setup.py 位置为与包同级的目录
-
from setuptools import setup


setup(
    name = "graphic",
    version = "0.1",
    py_modules = ["graphic.circle","graphic.rectangle"]
)
-
-
打开终端或者是dos命令窗口 切换到setup.py所在的位置
-
python setup.py build (表示构建操作 同时测试代码是否有问题)
-
pyhon setup.py sdist 生成压缩文件
-
再次通过pip命令安装压缩即可 因为是离线包 所以无需联网
-
5. 可迭代对象
可迭代对象 通过isinstance判断属于Iterable类型的就属于可迭代对象 反之则不属于可迭代对象
"""
    可迭代对象 通过isinstance判断属于Iterable类型的就属于可迭代对象
    反之则不属于可迭代对象
"""

from collections.abc import Iterable

print(isinstance("abc", Iterable))
print(isinstance([1,2,3], Iterable))
print(isinstance((1,2,3), Iterable))
print(isinstance({1,2,3}, Iterable))
print(isinstance({1:"A",2:"B"}, Iterable))
print(isinstance(123, Iterable))
print(isinstance(True, Iterable))
print(isinstance(False, Iterable))
print(isinstance(None, Iterable))
6. 迭代器
"""
    Iterator 迭代器 一个对象的类型如果属于Iterator
    表示此对象属于迭代器对象
"""
from collections.abc import Iterator

print(isinstance("abc", Iterator))
print(isinstance([1,2,3], Iterator))
print(isinstance((1,2,3), Iterator))
print(isinstance({1,2,3}, Iterator))
print(isinstance({1:"A",2:"B"}, Iterator))
print(isinstance(123, Iterator))
print(isinstance(True, Iterator))
print(isinstance(False, Iterator))
print(isinstance(None, Iterator))
print(isinstance((x for x in range(10)), Iterator)) # True 以上均为False
使用迭代器对象 iter()函数 用于获取迭代器对象 next()函数 用于获取下一个元素
"""
    使用迭代器对象
    iter()函数 用于获取迭代器对象
    next()函数 用于获取下一个元素
"""

list1 = [1,2,3,4]

it1 = iter(list1)
print(it1,type(it1))
print(next(it1))
print(next(it1))
print(next(it1))
print(next(it1))
# print(next(it1)) 这里就报错了 因为 元素已经遍历完了

tuple1 = (1,2,3,4)
it2 = iter(tuple1)
print(it2,type(it2))
print(next(it2))
print(next(it2))
print(next(it2))
print(next(it2))
# print(next(it2))这里就报错了 因为 元素已经遍历完了
自定义迭代器
"""
    鸭子多态:一个事物具备鸭子的行为 即可当做鸭子
"""


from collections.abc import Iterator,Iterable


class MyIterator:

    def __init__(self,data):
        self.data = data
        self.index = 0 # 初始化下标为0


    def __iter__(self):
        return self # 返回当前类对象 即得到一个迭代器

    def __next__(self):
        if self.index < len(self.data):
            cur_data = self.data[self.index]
            self.index += 1
            return cur_data # 返回数据
        else:
            raise StopIteration # 直接抛出异常 让程序停止


if __name__ == '__main__':
    it1 = MyIterator(["a","b","c","d","e"])
    print(isinstance(it1,Iterator))
    print(isinstance(it1,Iterable))

    # print(next(it1))
    # print(next(it1))
    # print(next(it1))
    # print(next(it1))
    # print(next(it1))
    # print(next(it1))


    for item in it1:
        print(item)
7. 鸭子多态(扩展,了解)
鸭子多态底层实现原理
无需自己调用 在合适的时机 会自行调用的函数 属于钩子函数
鸭子多态底层实现是通过钩子函数__subclasshook__ 来实现的 首先对类型做判断 仅限于当前类对象才可以进行属性的判断 这个判断用于避免这个钩子函数给子类误用 因为不同的事物有不同的 判断标准
"""
    鸭子多态底层实现原理

    无需自己调用 在合适的时机 会自行调用的函数 属于钩子函数

    鸭子多态底层实现是通过钩子函数__subclasshook__ 来实现的
    首先对类型做判断 仅限于当前类对象才可以进行属性的判断
    这个判断用于避免这个钩子函数给子类误用 因为不同的事物有不同的
    判断标准
"""

from abc import abstractmethod,ABCMeta

class Pet(metaclass=ABCMeta):  # 元类为ABSMeta

    @abstractmethod
    def eat(self):
        pass

    @abstractmethod
    def run(self):
        pass


    @classmethod
    def __subclasshook__(cls, subclass):
        if cls is Pet: #判断传入的是否为Pet类型  如果不是Pet则直接返回False
            has_eat = hasattr(subclass, "eat") and callable(subclass.eat)
            has_run = hasattr(subclass, "run") and callable(subclass.run)
            if has_eat and has_run:
                return True
        return False


class Dog:
    def eat(self):
        print("狗狗吃骨头")

    def run(self):
        print("狗狗在奔跑")

    def watch(self):
        pass

    @classmethod
    def __subclasshook__(cls, subclass):
        if cls is Dog: #判断传入的是否为Pet类型  如果不是Pet则直接返回False
            has_eat = hasattr(subclass, "eat") and callable(subclass.eat)
            has_run = hasattr(subclass, "run") and callable(subclass.run)
            has_watch = hasattr(subclass, "watch_door") and callable(subclass.watch_door)
            if has_eat and has_run and has_watch:
                return True
        return False


    pass


class Cat:
    def eat(self):
        print("猫咪吃小鱼")

    def run(self):
        print("猫咪在奔跑")

if __name__ == "__main__":

    d1 = Dog()
    print(isinstance(d1, Dog))
    print(isinstance(d1, Pet))

    print("---------------------------------------------------------")

    cat1 = Cat()
    print(isinstance(cat1, Cat))
    print(isinstance(cat1, Dog))
    print(isinstance(cat1, Pet))